ИИ не пишет, а ищет: как нейросети превращаются в исследователей
Генеративные нейросети приучили нас ждать от ИИ готовых текстов. Но куда больше пользы он приносит там, где ищет, сверяет и считает: в открытых данных и в уже опубликованных исследованиях. А главное — помогает продолжить чужую работу с той точки, где она остановилась.
От пишущей машины к исследователю
Почти четыре года, с момента появления ChatGPT в конце 2022, разговор об ИИ в медиа сводится к одному вопросу: заменит ли нейросеть автора. Тексты, картинки, озвучку ИИ действительно производит. Но самое ценное, что он может дать журналисту, аналитику или ученому, лежит в другой плоскости.
Нейросеть способна не писать за человека, а искать, проверять и сопоставлять то, что уже существует. Мир накопил гигантский массив открытых данных и научных работ: статистика, бюджеты, реестры, сотни миллионов публикаций. Проблема не в нехватке знания, а в том, что человек физически не успевает его прочесть.
Эта статья о другом способе работы с ИИ. Он ищет открытые данные и анализирует их. Он находит и сравнивает уже проведенные исследования. А затем помогает продолжить работу с той точки, где коллеги остановились, взяв у каждого лучшее. Когда находки разных команд соединяются, возникает синергия: результат, которого не дало бы ни одно исследование по отдельности.
Открытые данные: найти, очистить, посчитать
Открытых данных много, но они разбросаны, плохо описаны и часто устарели. ИИ полезен на трех этапах: найти нужный набор, привести его в порядок и посчитать. На каждом из них он экономит не минуты, а недели.
Найти. Вопрос на обычном языке («сколько регионы тратят на здравоохранение на душу населения») языковая модель с веб-поиском превращает в список первоисточников. Помогают и специализированные поисковики по наборам данных: Google Dataset Search и Dateno, который собирает метаданные из тысяч каталогов по всему миру.
В России эта задача особенно актуальна. Федеральный портал data.gov.ru закрыли в марте 2023 года и перезапустили 15 июля 2025. По подсчетам исследователя открытых данных Ивана Бегтина, на обновленном портале около 5,8 тыс. наборов общим объемом примерно 100 МБ в сжатом виде. Больше 80% из них содержат меньше 100 строк, около 84% опубликованы в 2019 году или раньше.
Вывод для журналиста простой: ценные данные живут не на центральной витрине, а в отраслевых системах. Официальную статистику публикует Росстат: только на сайтах ведомства и его территориальных органов размещено более 150 тыс. Excel-файлов. Бюджетные, налоговые и казначейские данные лежат на ресурсах Минфина, ФНС и Федерального казначейства. Городские и отраслевые наборы, которые обновляются автоматически из ведомственных систем, есть на порталах data.mos.ru и opendata.mkrf.ru.
Для международных сравнений подходят ряды Всемирного банка, ОЭСР, Евростата и UNdata. Пройти по десяткам разрозненных источников и свести их вместе — как раз та работа, где ИИ сильнее человека.
Очистить и посчитать. Современные ассистенты умеют выполнять код: они открывают CSV и Excel, исправляют форматы, объединяют наборы, считают и строят графики. Главное правило: просить ИИ не «ответить», а написать и выполнить расчет. Тогда каждая цифра в материале воспроизводима, а код можно показать редактору или эксперту.
Например, журналист загружает 85 региональных отчетов об исполнении бюджета. ИИ приводит их к единому виду, считает расходы на душу населения и отмечает регионы, которые резко выбиваются из общего ряда. Человеку остается главное: понять, почему так вышло, и позвонить тем, кто может это объяснить.
Чужие исследования: собрать, сравнить, найти противоречия
Прежде чем начинать свое исследование, нужно понять, что уже сделано. Масштаб задачи нечеловеческий: открытый каталог OpenAlex содержит около 278 млн научных работ, а с расширенным набором из репозиториев — больше 470 млн. Прочитать даже малую долю того, что относится к одной теме, невозможно.
ИИ-инструменты превращают недели чтения в часы. Но их главная ценность не в скорости, а в сравнении. Хороший обзор отвечает не на вопрос «что написано», а на вопрос «где авторы согласны, где расходятся и почему».
Каждой задаче соответствуют свои инструменты. Искать работы по смыслу, а не по ключевым словам, умеют Elicit, Semantic Scholar и Consensus: они находят статьи, даже если в них нет ваших формулировок. Elicit делает и следующий шаг — сводит результаты воедино: из каждой статьи извлекает выборку, метод и результат и подкрепляет ответ цитатой из текста.
Чтобы понять, выдержал ли вывод проверку временем, есть scite: он показывает, как работу цитируют другие — подтверждают, оспаривают или просто упоминают. ResearchRabbit, Connected Papers и Litmaps строят граф цитирований: видно, кто на кого опирается, где центр темы и где ее периферия. С метаданными напрямую можно работать через открытый каталог OpenAlex и его API. Русскоязычные работы стоит искать отдельно — в КиберЛенинке и на eLIBRARY.ru.
Отдельный класс — режимы «глубокого исследования» в универсальных ассистентах. Агент сам делает десятки поисковых запросов, читает источники и выдает отчет со ссылками. Это хорошая стартовая карта темы, но не готовый результат: каждую ссылку нужно открыть.
Специализированные платформы уже автоматизируют систематические обзоры. Elicit, по данным самой компании, ищет по более чем 138 млн статей и 545 тыс. клинических испытаний и экономит исследователям до 80% времени на обзоре. Независимые проверки осторожнее в оценках, и об этом ниже.
Самое полезное, что дает такая работа, — сравнение по единой схеме: выборка, метод, результат и ограничения каждого исследования. Когда выводы расходятся, причина почти всегда видна в этих деталях. Разные страны, разные годы, разные способы измерения. Именно там и начинается журналистская или научная история.
Продолжить с той точки, где остановились другие
Каждое честное исследование заканчивается признанием, где оно остановилось. Разделы «Ограничения» и «Направления дальнейших исследований» — это готовая карта нерешенных вопросов. Беда в том, что их почти никто не читает системно, сразу по сотням работ.
Для ИИ это посильная задача. Модель извлекает из каждой статьи заявленные ограничения и предложения на будущее, а затем группирует их. Если двадцать авторов подряд пишут «выборка ограничена одним регионом» или «данные заканчиваются 2019 годом», это уже не оговорка, а сигнал: здесь есть пробел.
Дальше пробел нужно проверить. Закрыл ли его кто-то позже? На этот вопрос отвечает поиск по цитированиям: какие работы ссылались на исходную и что в них сделано. Если никто не продолжил, остается последний вопрос: можно ли закрыть пробел открытыми данными, которые появились после публикации.
Типичные способы продолжить чужую работу:
- Продлить во времени. Исследование закончилось на данных 2019 года, а свежие ряды Росстата или Всемирного банка позволяют посмотреть, что изменилось.
- Перенести в другую географию. Вывод получен на одной стране; его можно повторить на российских регионах.
- Воспроизвести. Пересчитать результат на открытых данных авторов, если они их опубликовали, и проверить, держится ли он.
- Сменить выборку или метод. Проверить вывод на другой группе или другим способом измерения.
Точность здесь не стопроцентная. В работе Делфтского технического университета 2026 года модель нашла 91% явно заявленных ограничений на выборке из 78 статей, но только 71% ее выдачи были точными. Ограничения, которые авторы не выделили в отдельный раздел, она находила хуже. Вывод: ИИ хорошо собирает материал для карты пробелов, но саму карту проверяет человек.
Инструменты постепенно учатся следить за темой непрерывно. Например, в сентябре 2026 года Elicit запустил функцию Routines: агент регулярно ищет новые данные по заданной теме, обновляет обзор и отчитывается исследователю. Обзор литературы перестает быть снимком и становится живым документом.
Синергия: когда целое больше суммы исследований
Самое ценное новое знание часто лежит на стыке работ, которые никогда не ссылались друг на друга. Эту идею сформулировал еще в 1986 году американский информатик Дон Суонсон и назвал ее «неоткрытым общедоступным знанием».
Суонсон заметил две группы медицинских статей, у которых не было ни одной общей ссылки. В одной описывалось, что рыбий жир снижает вязкость крови и меняет работу сосудов. В другой — что у пациентов с синдромом Рейно такие изменения могли бы облегчить болезнь. Соединив их, он предположил, что рыбий жир поможет при синдроме Рейно, и через несколько лет это независимо подтвердило клиническое исследование. Тем же способом, через одиннадцать косвенных связей, Суонсон вывел гипотезу о роли дефицита магния в мигрени.
Суонсон искал такие связи вручную, по каталогу MEDLINE. Сегодня это делают ИИ-системы, и масштаб другой:
- Google AI co-scientist (2025). Команда Хосе Пенадеса из Имперского колледжа Лондона около десяти лет изучала, как устойчивость к антибиотикам распространяется между видами бактерий. Результат еще не был опубликован, когда ученые задали системе тот же вопрос. Через два дня их собственная гипотеза оказалась первой в списке ИИ, а среди остальных была еще одна, которую команда раньше не рассматривала (препринт Google).
- Robin от FutureHouse (2025). Мультиагентная система сопоставила литературу о сухой форме возрастной макулярной дегенерации и предложила ripasudil — препарат, одобренный в Японии от глаукомы. В лабораторных опытах на клетках он заметно усилил нужный эффект. Это пока доклиническая гипотеза, а не лекарство.
Для журналиста и аналитика синергия работает так же, только без лаборатории. У каждого исследования есть сильная сторона: в одном лучшие данные, в другом точный метод, в третьем удачная выборка. Задача — взять у каждого лучшее и соединить.
Например, одна работа предлагает надежную методику, но проверяет ее на одном регионе. Другая опирается на общенациональные открытые данные, но считает грубо. Применив метод первой к данным второй, можно получить результат, которого нет ни у одного из авторов. ИИ помогает увидеть такие пары, потому что держит в поле зрения сотни работ сразу.
Важная оговорка: синергия рождает гипотезы, а не выводы. Идеи Суонсона подтверждали клинические испытания, гипотезы co-scientist — лабораторные эксперименты. В журналистике роль эксперимента играют проверка данных, разговор с экспертами и с авторами исходных работ.
Рабочий алгоритм: от вопроса до публикации
Весь подход укладывается в шесть шагов. Поиск данных и поиск исследований идут параллельно и сходятся в карте пробелов.
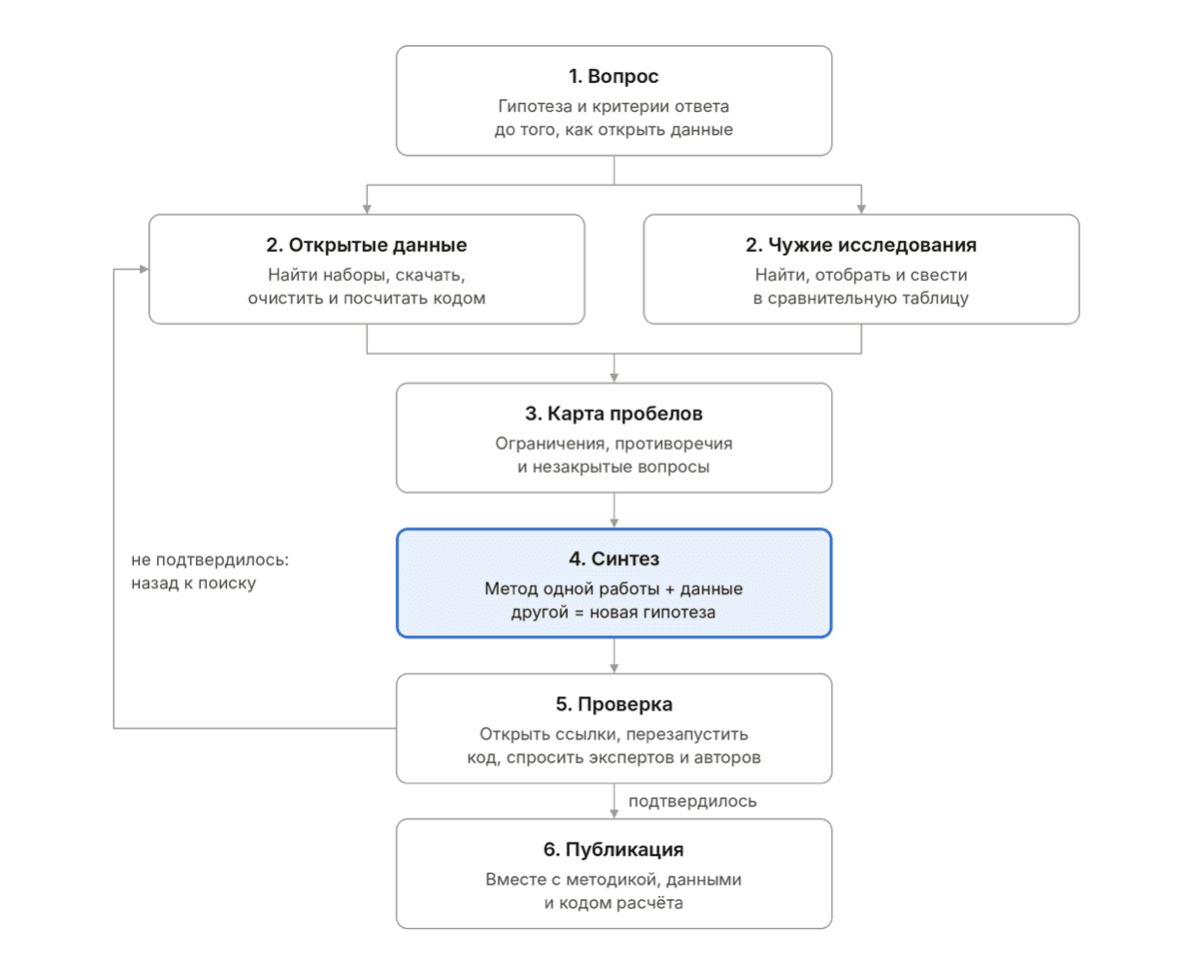
Если проверка не подтверждает гипотезу, работа возвращается к поиску, а не идет в печать.
Примеры запросов, которые переводят ИИ из режима автора в режим исследователя:
- «Найди открытые наборы данных о … за 2015–2025 годы. Для каждого укажи владельца, период, формат и ссылку».
- «Извлеки из этих 40 статей выборку, метод, главный результат и ограничения. К каждому ответу дай цитату и номер страницы».
- «Сгруппируй ограничения по типам и отметь, какие из них не закрыты более поздними работами».
- «Напиши и выполни код, который объединит эти файлы и посчитает показатель на душу населения. Покажи код целиком».
Риски: где ИИ-исследователь ошибается
ИИ, который ищет и анализирует, ошибается иначе, чем ИИ, который пишет, но не реже. Цена ошибки при этом выше: читатель доверяет цифре и ссылке больше, чем гладкому тексту.
Самый известный провал последнего времени — отчет Deloitte для правительства Австралии. В 237-страничном документе стоимостью 440 тыс. австралийских долларов нашли выдуманную цитату из решения федерального суда и ссылки на несуществующие научные работы. Компания согласилась вернуть часть денег, а в исправленной версии указала, что при подготовке использовалась языковая модель.
Выдуманные источники. Ссылки на несуществующие статьи, неверные цитаты, перепутанные авторы — самая частая ошибка. Защита одна: открыть каждую ссылку, найти цитату в оригинале, проверить DOI.
Неточное и невоспроизводимое извлечение. В независимой проверке Elicit, опубликованной в журнале Research Synthesis Methods в 2026 году, лишь 69% переменных на новых статьях дали заданную точность в 87%. При повторе с другого аккаунта совпали 90% значений, но только 46% подтверждающих цитат. Поэтому ИИ стоит использовать как второго экстрактора рядом с человеком, выборочно проверять его работу и фиксировать версию инструмента и дату.
Поиск закономерностей «на удачу». В журнале PLOS Biology описали 341 однотипную статью на открытых данных американского опроса здоровья NHANES: одна переменная против одной болезни, без учета других факторов и без поправки на множественные сравнения. Гипотезу нужно формулировать до анализа, а расчет отдавать на проверку статистику.
Устаревшие данные. На data.gov.ru около 84% наборов опубликованы в 2019 году или раньше, а свежая дата в описании не гарантирует свежих данных. Проверять стоит период, который покрывают сами данные, а не дату в карточке набора.
Перекос источников. Инструменты лучше видят англоязычные статьи в открытом доступе, а российские данные часто не индексируются международными поисковиками. Русскоязычные базы надо добавлять вручную и прямо писать об ограничениях выборки.
Утечка конфиденциального. Загружая в облачный сервис неопубликованные документы или материалы источников, журналист теряет над ними контроль. Перед загрузкой нужно прочитать политику хранения данных, обезличить материалы и не загружать то, что защищает источник.
У той же проверки Elicit есть и обнадеживающий результат: ИИ нашел восемь ошибок в эталонных данных, которые до этого перепроверяли сами исследователи. Это лучшая формула роли ИИ в исследовании — второй рецензент, а не первый автор.
Вместо вывода: усилитель, а не замена
Генеративный ИИ сделал текст дешевым. Поэтому дорожает то, что нельзя сгенерировать: проверенный факт, точная цифра, честное сравнение и новый вывод, которого раньше не было.
Для редакций это означает смену конкурентного преимущества. Выигрывает не тот, кто быстрее пишет, а тот, кто глубже копает и может показать, на чем держится каждое утверждение. ИИ в роли исследователя дает именно это: он находит данные, сводит чужие работы, показывает пробелы и подсказывает неочевидные связи.
Меняется и сам вопрос, который мы задаем машине. Не «напиши статью о…», а «найди данные, сравни исследования, посчитай и покажи источник». Вопрос, суждение, проверка и ответственность остаются за человеком. Машина помнит все, но решает, что важно, журналист.
Сорок лет назад Дон Суонсон вручную доказал, что новое знание можно найти в уже опубликованном. Сегодня инструмент, который делает это за часы, есть у каждого редактора. Осталось научиться использовать его как исследователя, а не как автора.